Ta strona używa plików cookies, aby zapewnić najlepszą jakość korzystania z naszego serwisu oraz do celów analitycznych. Klikając "Akceptuję", wyrażasz zgodę na używanie wszystkich plików cookies. Możesz również odrzucić zgodę, co spowoduje zablokowanie plików cookies analitycznych. Więcej informacji znajdziesz w naszej Polityce Prywatności.
AI zderza się z fizyką. Sieci energetyczne, chłodzenie i interkonekty hamują rozwój centrów danych
Szafy GPU mogą pobierać ponad 50 do 100 kW, co przekracza możliwości tradycyjnego chłodzenia powietrzem.
Miedziane interkonekty ograniczają przesył danych w dużych klastrach GPU, dlatego rośnie znaczenie połączeń optycznych.
Przyłączenie nowych centrów danych do sieci może wymagać od dwóch do czterech lat, a w Northern Virginia nawet do 14 lat.
Operatorzy inwestują w chłodzenie cieczą, transformatory półprzewodnikowe i lokalne źródła energii.
Sponsorowane
Odkryj rewolucyjną metodę nauki języków
Sprawdź jak w 30 dni opanować podstawy dowolnego języka obcego bez wychodzenia z domu.
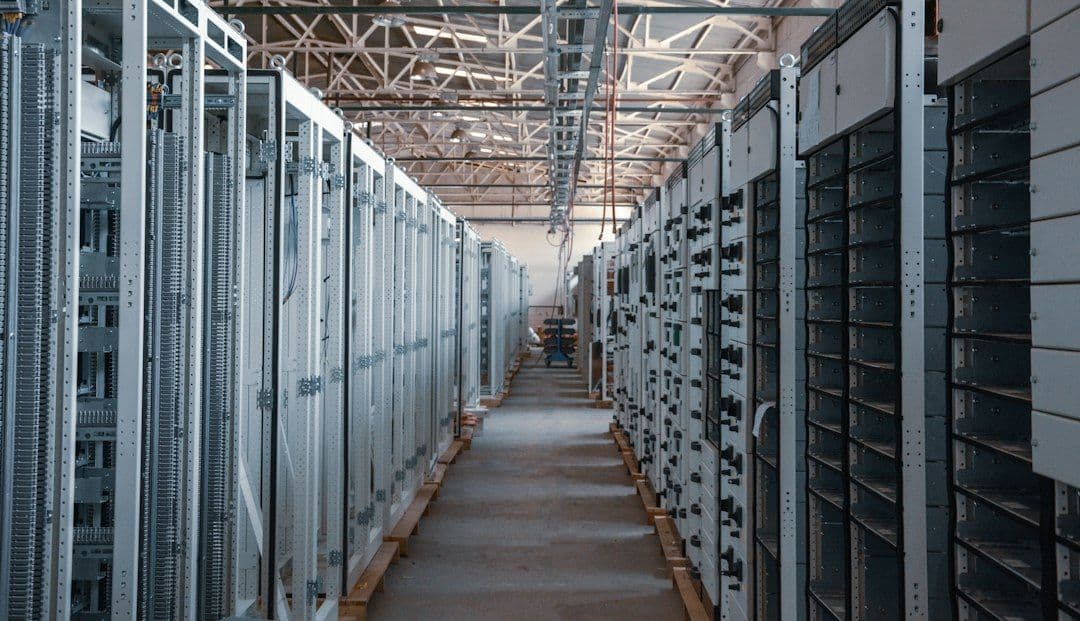
Rozwój sztucznej inteligencji coraz wyraźniej zależy od infrastruktury, a nie wyłącznie od kolejnych generacji procesorów. Centra danych budowane z myślą o dużych modelach AI muszą radzić sobie z trzema naraz występującymi problemami: ograniczoną przepustowością sieci energetycznych, rosnącą ilością ciepła oraz przesyłaniem danych pomiędzy dużymi klastrami GPU. Każde z tych ograniczeń może opóźniać uruchomienie nowych obiektów albo zwiększać koszt ich budowy i eksploatacji.
Źródło opisuje sytuację jako zderzenie rewolucji krzemowej z fizycznymi granicami infrastruktury. Centra danych AI zwiększają pobór energii i gęstość obliczeń szybciej, niż tradycyjne systemy zasilania, chłodzenia oraz komunikacji między układami są w stanie się dostosować. Operatorzy odpowiadają na te problemy nowymi rozwiązaniami, ale wiele z nich jest droższych, bardziej złożonych albo dopiero przygotowywanych do wdrożeń na dużą skalę.
Gęstość mocy GPU przekracza możliwości chłodzenia powietrzem
Najbardziej bezpośrednim problemem jest ciepło. Szafy serwerowe z wydajnymi procesorami graficznymi mogą pobierać ponad 50 do 100 kW mocy na jeden zestaw. Energia elektryczna zużywana przez GPU w praktyce zamienia się w ciepło, które trzeba nieustannie odprowadzać. Systemy chłodzenia mogą utrzymywać klastry w zakresie około 65 do 85 stopni Celsjusza, lecz przy temperaturach od 90 do 100 stopni układy zaczynają ograniczać wydajność, aby uniknąć trwałego uszkodzenia.
Tradycyjne chłodzenie powietrzem projektowano z myślą o szafach o gęstości mocy rzędu 30 do 40 kW. Klastry AI łatwo przekraczają ten poziom, a konfiguracje o mocy 100 kW lub większej stają się coraz częstsze. Aby przepchnąć przez taką szafę wystarczającą ilość powietrza, operatorzy musieliby uruchamiać wentylatory z bardzo wysoką prędkością. Zwiększa to zużycie energii i pogarsza wskaźnik
Słownik artykułu
Pojęcia, które warto znać
Krótkie objaśnienia terminów występujących w tekście. Każde hasło prowadzi do szerszej definicji i przykładów użycia.
, ponieważ większa część energii trafia do infrastruktury pomocniczej zamiast bezpośrednio do obliczeń.
Szafy GPU o mocy ponad 50 do 100 kW generują więcej ciepła, niż mogą skutecznie odprowadzić typowe systemy powietrzne.
Przekroczenie temperatury około 90 do 100 stopni Celsjusza może uruchomić ograniczanie wydajności GPU.
Bardzo intensywny przepływ powietrza zwiększa pobór energii przez wentylatory i pogarsza PUE centrum danych.
Przy dużych gęstościach mocy operatorzy coraz częściej przechodzą na chłodzenie bezpośrednio przy układzie albo chłodzenie cieczą.
Samo zwiększanie przepływu powietrza nie rozwiązuje problemu. Dla największych klastrów potrzebny byłby przepływ porównywany w źródle do huraganowego, co jest trudne do zastosowania w praktycznym centrum danych. Alternatywą jest chłodzenie cieczą. W klasycznym układzie zimna płyta z mikrokanałami znajduje się bezpośrednio przy procesorze i wymusza przepływ cieczy, która odbiera ciepło z powierzchni układu. Problemem pozostaje jednak konieczność pompowania odpowiedniej ilości cieczy przez bardzo małe kanały, co także wymaga energii.
Ciecz, para i zamknięte obiegi
Jednym ze sposobów ograniczania tego narzutu jest montowanie zimnych płyt bezpośrednio na procesorach, a nie nad nimi. Takie chłodzenie bezpośrednio przy układzie ma skrócić drogę odbioru ciepła i zmniejszyć zapotrzebowanie na pompowanie. Operatorzy testują również chłodzenie dwufazowe, znane po angielsku jako two-phase immersion cooling. W tym rozwiązaniu ciecz dielektryczna ma bezpośredni kontakt z gorącymi GPU. Pod wpływem ciepła paruje, odbierając energię z układu, a następnie dociera do skraplacza, gdzie zamienia się z powrotem w ciecz i wraca do zbiornika.
Wykorzystanie przemiany fazowej pozwala reagować na gwałtowne skoki temperatury w szafach o wysokiej gęstości mocy. Według materiału takie chłodzenie może ograniczyć energię zużywaną na chłodzenie nawet o 40 procent. Nie oznacza to jednak prostego zastąpienia istniejących instalacji. Systemy dwufazowe wymagają specjalistycznych cieczy, odpowiedniej konstrukcji zbiorników i infrastruktury dopasowanej do pracy z parą oraz skraplaniem.
Inną drogą są zamknięte obiegi cieczy. Microsoft zastosował takie rozwiązanie w nowszych centrach danych. Woda jest napełniana raz, następnie przepływa przez serwery, odbiera ciepło, trafia do chłodnic chłodzonych powietrzem i wraca do obiegu. Ogranicza to potrzebę regularnego uzupełniania zapasów wody, ale system jest kosztowny i wymaga czasu, aby wdrożyć go na dużą skalę. Przykład pokazuje, że problem chłodzenia staje się równie ważny jak wybór samych układów obliczeniowych.
GPU w dużych klastrach muszą wymieniać dane, współdzielić pamięć i przekazywać sobie zadania. Przez lata podstawą takich połączeń były interkonekty elektryczne wykonane z miedzi. Przy rosnących obciążeniach ich ograniczenia stają się jednak coraz bardziej widoczne. Sygnał elektryczny traci siłę na większych odległościach, szczególnie powyżej około dwóch metrów. W źródle wskazano również, że użyteczny zasięg zmniejsza się o połowę za każdym razem, gdy wymagania dotyczące przepustowości się podwajają.
Gęsto ułożone przewody miedziane wytwarzają zakłócenia elektromagnetyczne, które mogą wpływać na sąsiednie sygnały. Aby je kompensować, potrzebne są złożone układy korekcji, a te zużywają dodatkową energię. Dochodzą do tego straty wynikające z oporu elektrycznego w miedzianych ścieżkach płytek GPU. Im większy prąd płynie przez przewodniki, tym więcej powstaje ciepła. W efekcie interkonekty miedziane nie tylko ograniczają przesyłanie danych, ale także zwiększają obciążenie systemu chłodzenia.
Dlatego operatorzy zwracają się ku połączeniom optycznym. Dane są w nich zamieniane na impulsy światła i przesyłane światłowodami, które mogą zachować jakość sygnału na większych odległościach niż miedź. Cieńsze przewody optyczne tworzą też więcej przestrzeni dla przepływu powietrza w gęsto zabudowanych szafach. Kolejnym etapem może być silicon photonics, czyli co-packaged optics, określane po polsku jako optyka współpakietowa. W takim podejściu obwody optyczne są umieszczane bezpośrednio przy GPU lub w jego pakiecie.
Barierą pozostaje cena. W niektórych konfiguracjach GPU połączenia optyczne mogą kosztować nawet siedem razy więcej niż rozwiązania elektryczne. Mimo tego źródło wskazuje, że w krótkim okresie operatorzy mogą być zmuszeni zaakceptować ten koszt, ponieważ tradycyjna miedź zbliża się do swoich fizycznych ograniczeń. Szersze wdrożenia i produkcja na większą skalę mogą z czasem obniżyć ceny.
Sieć energetyczna staje się wąskim gardłem
Największym ograniczeniem dla nowych centrów danych może być jednak samo przyłączenie do sieci. W latach 2021 do 2025 na świecie dodano 30 GW nowej mocy związanej z rozwojem infrastruktury AI. Tak szybki wzrost obciąża dostawy komponentów sieciowych i wydłuża procesy projektowe. Jednym z najbardziej widocznych problemów są transformatory wysokiego napięcia, potrzebne do bezpiecznego dostarczania energii do klastrów GPU.
Czas oczekiwania na takie transformatory wzrósł z około sześciu do 12 miesięcy w 2020 roku do dwóch do czterech lat obecnie. To okres znacznie dłuższy niż harmonogram, w którym kosztowny klaster GPU może rozpocząć pracę po ukończeniu budowy. Dodatkowym wyzwaniem są szybkie zmiany poboru energii. Zapotrzebowanie klastra może zmienić się w ciągu sekund, gdy stabilny pobór podczas niskiego obciążenia wnioskowania zostaje zastąpiony nagłym skokiem związanym ze wzrostem wykorzystania.
Takie wahania tworzą złożone harmoniczne, które mogą przegrzewać transformatory i wpływać na działanie sieci. Wraz ze skalowaniem klastrów do poziomu gigawatów rośnie także obciążenie aparatury rozdzielczej obniżającej napięcie. Większe transformatory zmniejszają impedancję elektryczną, co może prowadzić do bardzo wysokich prądów zwarciowych. W razie zwarcia pola magnetyczne mogą wywierać silne siły mechaniczne na szyny rozdzielnic, powodując ich odkształcenie albo wyrwanie z mocowań.
Jedną z odpowiedzi są transformatory półprzewodnikowe, określane także jako solid-state transformer. Zamiast opierać redukcję napięcia głównie na polu magnetycznym, wykorzystują energoelektronikę wysokiej częstotliwości i półprzewodniki. Dzięki temu mogą aktywnie regulować napięcie oraz filtrować harmoniczne. Według źródła ich sprawność wynosi od 97 do 99 procent, w porównaniu z 95 do 97 procent w przypadku konwencjonalnych transformatorów. Różnica wynosząca jeden do dwóch punktów procentowych może mieć duże znaczenie przy centrach danych o mocy liczonej w gigawatach.
SST są również mniejsze i lżejsze, co może ułatwiać logistykę oraz szybsze wdrażanie. Mają jednak własne ograniczenia. Wewnętrzne komponenty wysokiej częstotliwości i układy sterujące są kosztowne, a cena w przeliczeniu na kVA może być co najmniej pięć razy wyższa niż w przypadku rozwiązań niskoczęstotliwościowych. Kilka etapów konwersji, takich jak AC do DC oraz DC do AC lub DC do DC, powoduje kumulowanie się strat. Elementy wewnętrzne wytwarzają też ciepło i mogą starzeć się szybciej, co zwiększa wymagania dotyczące obsługi.
Firmy próbują równolegle zwiększać dostępność tej technologii. Siemens, drugi największy producent transformatorów na świecie, nawiązał współpracę z niemiecką firmą Reinhausen przy masowej produkcji modułowego transformatora półprzewodnikowego dla centrów danych AI. Nie rozwiązuje to natychmiast problemu niedoboru konwencjonalnych transformatorów, ale pokazuje kierunek rozwoju infrastruktury zasilającej.
Ponieważ nowe rozwiązania nie są jeszcze dostępne na odpowiednią skalę, część operatorów buduje własne systemy zasilania i stacje elektroenergetyczne po stronie odbiorcy, zanim uzyska pełne przyłączenie do lokalnej sieci. Firma xAI dodała 59 przenośnych turbin gazowych o łącznej mocy przekraczającej 400 MW, aby zasilać centrum danych Colossus w Memphis w stanie Tennessee podczas oczekiwania na przyłączenie. Inni operatorzy rozważają małe reaktory modułowe, czyli SMR, ale to rozwiązanie pozostaje w dużej mierze na etapie koncepcyjnym i jest obecnie znacznie droższe od turbin gazowych lub źródeł odnawialnych.
Długie kolejki do przyłączeń mogą hamować budowę
Problem nie dotyczy tylko pojedynczych projektów. Northern Virginia, największy na świecie klaster centrów danych, obejmuje około 570 obiektów i nadal się rozrasta. Nowe placówki mogą tam czekać na przyłączenie do sieci nawet 14 lat. Dla operatorów oznacza to konieczność planowania mocy, chłodzenia i lokalizacji z wieloletnim wyprzedzeniem, a także szukania tymczasowych lub dodatkowych źródeł zasilania.
Operatorzy amerykańskiej sieci inwestują w rozbudowę infrastruktury. Według Edison Electric nakłady wyniosły 208 miliardów dolarów w 2025 roku, a planowane inwestycje na lata 2025 do 2030 sięgają 1,1 biliona dolarów. Mimo tej skali nadal trudno nadążyć za popytem generowanym przez centra danych. Potrzebne są zarówno kolejne inwestycje w sieci, jak i technologie ograniczające zużycie energii przez same obiekty.
Rozwój infrastruktury AI nie zależy więc wyłącznie od tego, jak szybkie będą nowe GPU. Konieczne jest jednoczesne rozwiązanie problemów transportu energii, stabilności sieci, odprowadzania ciepła oraz komunikacji między układami. Chłodzenie cieczą, połączenia optyczne, transformatory półprzewodnikowe i lokalne źródła energii mogą zmniejszyć część ograniczeń, ale każde z tych rozwiązań wiąże się z dodatkowymi kosztami, wymaganiami technicznymi albo długim okresem wdrożenia. To właśnie infrastruktura, a nie sam krzem, może w najbliższych latach wyznaczać tempo rozbudowy mocy obliczeniowych AI.